
第 5 回卒研ゼミ
説明スクリプト & 用語リスト
エッジデバイス向け 3D Gaussian Splatting 統合パイプラインの検討 ― 第 3 回以降の進捗
説明スクリプト
-84%」と「既存実装との比較」の 2 本。比較では、速度は brush と同等・msplat には 2.5 倍差、品質は評価器によって逆転することを正直に言う (第 3 回の +0.63 dB の訂正を含む)。第 4 回は欠席のため、前回 = 第 3 回。下線つきの用語はタップで意味が出る。 1. 概要 about 30 sec
本研究では、Apple Silicon 搭載端末上で 3D Gaussian Splatting の学習から表示までを 1 台で完結させるパイプラインの構築を目指しています。第 4 回は欠席したため、今回は第 3 回以降の報告になります。
内容は大きく 3 つで、研究範囲の整理、学習の高速化、既存実装との比較です。学習の高速化では、Lego 12,500 反復の学習時間を 766 秒から約 123〜126 秒、84% 短縮しました。既存実装の msplat と brush とは同じ日・同じ機体で比較し、速度は brush とほぼ同等、msplat とは同じ反復数で 2.5 倍の差が残ること、そして品質の優劣は評価器によって逆転することが分かりました。
- 3 つの柱
- 研究範囲の整理 ( 打ち切り、実写 )
- 学習の高速化: Lego 12.5k
766 s → 122.8〜126.1 s(-84%) - 既存実装との比較: 速度は と同等、 の 2.5 倍 / 品質はで逆転
2. 研究範囲の整理 about 40 sec
まず研究範囲の整理です。3DGS-MCMC の欠陥修正は、成分ごとに切り分けて scale 正則化項が単独で 4.4 dB 悪化させることまで特定しましたが、それを除いても 30,000 反復で 14.7 dB にとどまり、5 回続けて改善しなかったので打ち切りました。
また、実写データの Mip-NeRF 360 bicycle で学習したところ、PSNR 15.55 dB で論文値より 9.7 dB 低い結果でした。refine の停止反復と点数上限を実写向けに変えても 0.05 dB しか改善しなかったので、原因は別の部分にあると考えています。以上から、本研究の評価範囲は合成・物体中心のデータセットに絞ります。
- — 打ち切り
- で が単独で
-4.4 dBと特定、除いても 30k で14.7 dB、5 連続で改善なし
- で が単独で
- 実写 — 評価範囲から外す
15.55 dB(論文 25.25 dB から-9.7 dB)、の調整で+0.05 dBのみ- 原因候補: 間隔 / 閾値 / の偏り
- → 評価範囲はに絞る
3.1 計測方法 about 30 sec
高速化の効果は数 % のものが多いので、計測のばらつきと区別するための手順を決めました。各手法は設定 1 行で ON/OFF できるようにし、学習済み点群を固定したベンチで候補を絞ったうえで、Lego 12,500 反復を ON と OFF 交互に 3 回ずつ同じセッションで計測します。差が 2σ か 1% の大きい方を超え、PSNR が下がらない場合だけ採用しています。
- 要点
- (
σ = 0.83%) で候補を絞る - 各 3 回、閾値
max(2σ, 1%)+ PSNR 低下なし - 計算結果が変わらない手法は出力の一致をテストで確認、AC 電源 + 負荷記録
- (
3.2 採用した手法 about 1 min 20 sec
開始時点のプロファイルでは、学習時間の 55% がタイルへの振り分けとソートでした。ただし原因はカーネルではなく、毎反復 約 1.25 GB のバッファを確保し直していたことによるページフォールトでした。これを常駐バッファに置き換えるだけで 48.4% 短縮しました。
以降もプロファイル上で一番大きいところから順に対処し、採用したのは表 1 の 10 手法です。効果が大きかったのは、中間バッファ全般の常駐化で 22%、反復をまたいで CPU と GPU の処理を重ねるパイプライン化で 18%、基数ソートの SIMD 化で 15% です。GPU の稼働率は 69% から 91% まで上がり、PSNR は全段階で 36.2 dB 前後のままです。10 手法はすべて計算結果を変えない変更です。
最大の改善がカーネル最適化ではなくバッファ管理から得られたのは、CPU と GPU がメモリを共有するユニファイドメモリならではの知見で、研究の第 3 軸に関わると考えています。
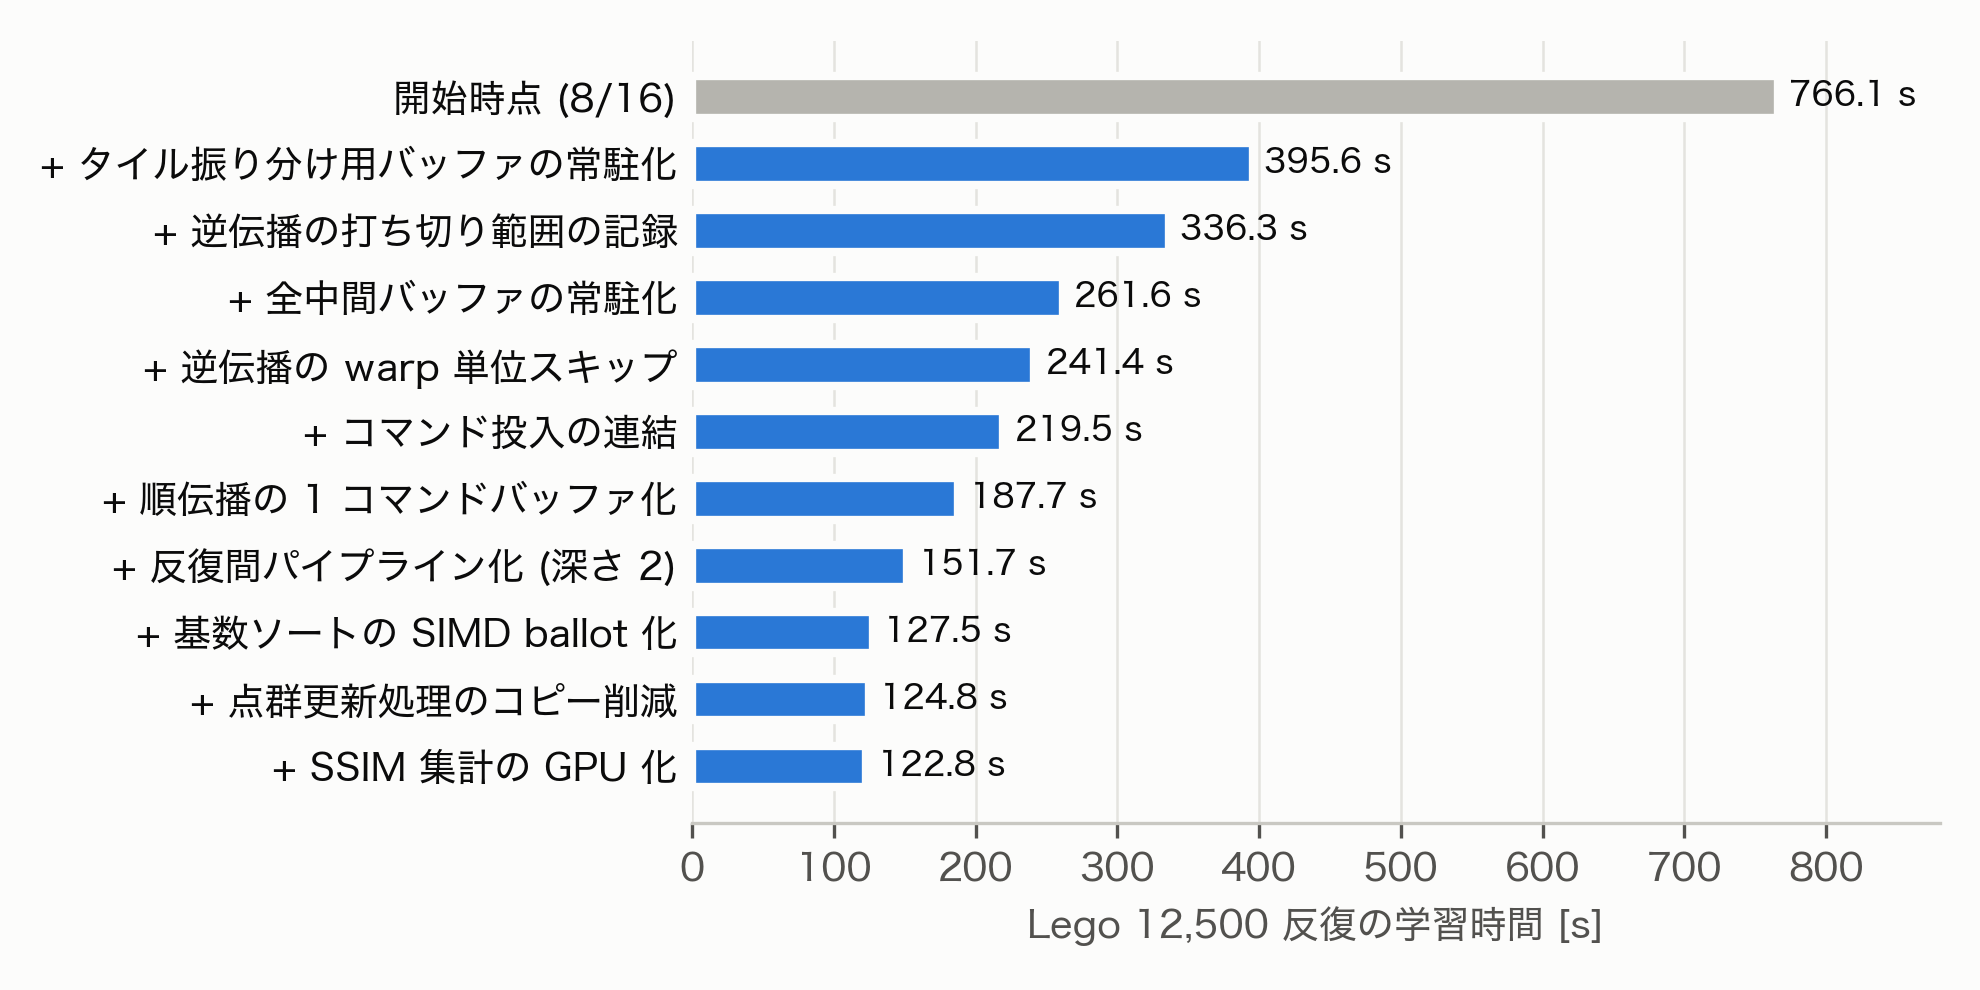
- 効果の大きい順
- 用バッファの
-48.4%(、実需要の約 80 倍を毎反復確保) - 全中間バッファの常駐化
-22.2%(約 46 MB の確保 + 約 57 MB の再転送を撤廃) -
-18.1% - 逆伝播の打ち切り範囲の記録
-15.0%(最後に寄与した点から逆伝播を開始) -
-14.9% - 順伝播の 1 化
-9.9%() / コマンド投入の連結-9.1%/ 単位スキップ-7.7% - 点群更新のコピー削減
-2.2%/ SSIM 集計の GPU 化-1.4%
- 用バッファの
- 補足
- 最終値は幅: 同日対照
122.8 s/ 静穏時再計測126.1 s(長時間計測で原因不明の +3〜6%) -
68.9% → 91.3%(で最大の要素から順に対処)
- 最終値は幅: 同日対照
3.3 採用しなかった手法 about 30 sec
採用しなかった 9 手法も記録しています。StopThePop 型のタイル判定や、brush で使われている splat 単位の逆伝播など、他の実装で有効とされる手法も、本実装では効果がないか逆に遅くなりました。また主要なカーネルを調べたところ、Adam はすでにメモリ帯域の 9 割に達していて、計算結果を変えない範囲では 1% を超える改善余地は見つかりませんでした。
- 要点
- 型: 単独
-2.5%、他手法と併用で+2.2%(常駐化と効果が重複) - (brush 型):
+34% - はの 90〜93% に到達済み
- densify 間隔 200:
-25%だが PSNR-0.42 dB・点数 -35% → 最適化ではない - GPU 時間の内訳: 逆伝播 40% / Adam 15% / 順伝播 14% / SSIM 13% / ソート 12%
- 型: 単独
4.1〜4.3 既存実装との比較 about 1 min 30 sec
次に既存実装との比較です。msplat と brush、それぞれと本実装を同じ日・同じ機体で、Lego を 30,000 反復学習して比べました。PSNR は、各実装が自分で出す値に加えて、本実装の評価器と brush の評価器の両方で同じ点群を評価しています。
学習時間は、msplat の 2.5 倍、brush の 0.94 倍でした。brush との差は 1 回ずつの計測のばらつき程度なので、ほぼ同等です。5 月の時点では brush の 3 倍近くかかっていたので、大きく改善しました。
品質については、本実装の評価器では本実装が一番高く、brush の評価器では brush が一番高いという結果になりました。どちらの評価器も、自分のレンダラで学習した点群を約 1.9 dB 高く評価します。第 3 回で「brush より 0.63 dB 高い」と報告しましたが、あれも本実装の評価器で測った値だったので、品質で上回っているとは言えない、と訂正します。各実装が自分で測った値同士では、msplat とは互角、brush には 1 dB 劣ります。
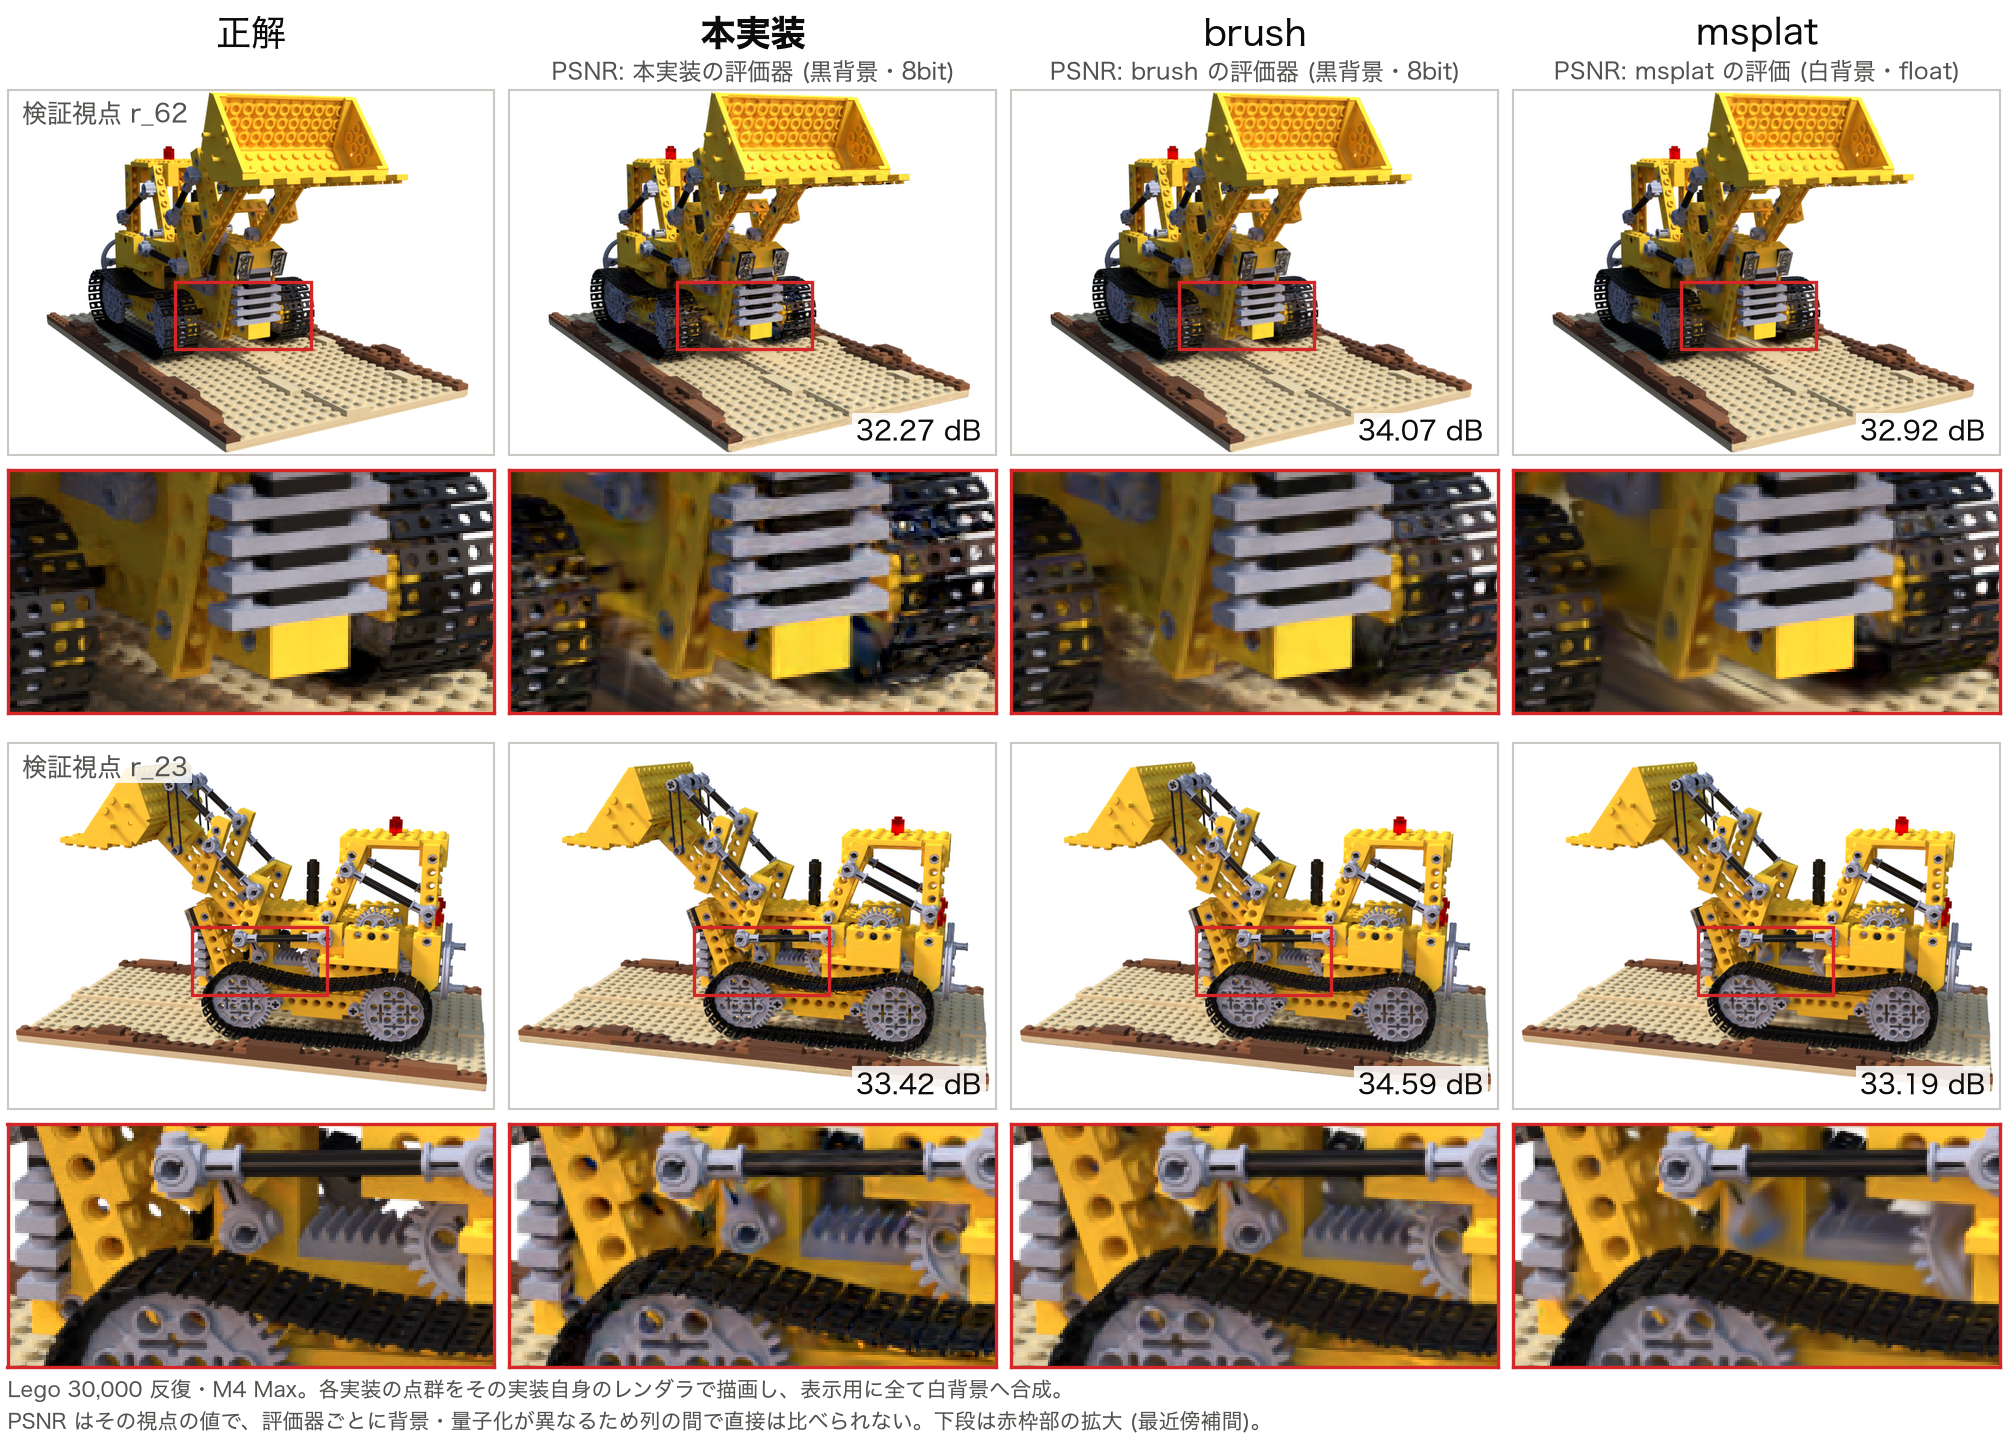
図 2 は同じ視点を各実装自身のレンダラで描画したものです。全体像はどれも正解とほぼ同じですが、拡大すると、影になったキャタピラ付近で本実装にざらついたノイズがあり、brush が一番正解に近いです。側面の視点では msplat のギアの歯がぼやけています。
msplat との 2.5 倍の差は、最終点数の比 2.56 倍とほぼ同じで、1 点・1 反復あたりの処理時間は msplat の 0.92 倍です。なので、差の大部分は GPU の処理効率ではなく、densify で点が多いことによると考えています。
| 実装 (計測日) | 学習時間 | 各実装の評価 | 本実装の評価器 | brush の評価器 | 最終点数 |
|---|---|---|---|---|---|
| msplat (8/31) | 165.7 s | 36.46 | 33.93 | — | 191,941 |
| 本実装 (8/31) | 413.6 s | 36.46 | 36.50 | — | 490,866 |
| brush (9/23) | 417.0 s | 37.41 | 34.57 | 37.41 | 284,151 |
| 本実装 (9/23) | 392.4 s | 36.42 | 36.47 | 35.58 | 485,825 |
- 速度
- の
2.50 倍(30k 同士)、 の0.94 倍(ばらつき内でほぼ同等) - 12.5k 対 30k なら 0.75 倍だが反復数が違うので主張しない
- の
- 品質 — 評価器で逆転
- どちらのも自分のレンダラで学習した点群を約
1.9 dB有利に評価 - 違いの候補: /
- 第 3 回の「brush 比 +0.63 dB」も本実装の評価器による値 → 訂正
- 自分の評価器同士: msplat と互角、brush に
-1.0 dB
- どちらのも自分のレンダラで学習した点群を約
- msplat との差の見立て
- 点数比
2.56 倍≒ 速度差、1 点・1 反復あたりは0.92 倍→ による点数差が主因 (仮説)
- 点数比
4.4 他シーンでの確認 about 20 sec
採用した手法は Lego でしか評価していなかったので、4 シーンを 30,000 反復で学習して 5 月の結果と比べました。学習時間は 5 〜 6 倍速くなり、PSNR の差はいずれも小さいです。ただ ficus は同じ設定でも PSNR が 1.4 dB ばらつくので、シーンごとにばらつきを確認する必要があります。
5. 今後の方針 about 30 sec
今後は、まず評価器によって優劣が逆転する原因を特定し、実装間で公平に品質を比べられる評価方法を確立します。次に、materials で msplat の学習が崩れる現象を同じ条件で確認し直すこと、msplat の平均点数を実測して点数と速度・品質の関係を調べることです。あわせて、今回の結果を卒業論文の評価の章としてまとめ始めます。以上です。
- 4 項目
- 評価器の差の原因特定 → 公平な評価方法
- materials で msplat の崩れを同条件で再確認
- msplat の平均点数を実測、densify 設定と速度・品質の関係
- 卒論の評価の章をまとめ始める
用語リスト
スクリプト中の下線つき語は本リストの内容をポップアップで表示する。第 3 回ゼミからの継続語は最後にまとめて再掲。
今回の新出語
- msplatApple Silicon ネイティブ (Metal) の 3DGS 実装。今回から比較対象に追加。Lego 30,000 反復
165.7 s - バッファの常駐化毎反復確保し直していた GPU バッファを使い回すこと。今回最大の短縮 (
-48.4%) の源 - ページフォールト新しく確保したメモリに初めて触れたとき OS が物理ページを割り当てる処理。毎反復 約 1.25 GB の再確保で大量に発生していた
- コマンドバッファGPU に投げる処理をまとめた単位 (MTLCommandBuffer)。投入ごとに CPU の待ちが生じうるので、まとめると速くなる
- 反復間パイプライン化反復 N の逆伝播の完了を待たずに反復 N+1 の順伝播を投入し、CPU の後処理を GPU 実行の裏に隠すこと
- 基数ソート / SIMD ballot基数ソートは桁ごとに並べ替えるソート。ballot は SIMD グループ (32 スレッド) の各スレッドの真偽を 1 命令で集める命令で、順位計算を逐次から 2 段計算に置き換えた
- 交互 A/B 計測手法の ON/OFF を同一セッション内で交互に各 3 回回し、差が
max(2σ, 1%)を超え PSNR が下がらない場合のみ採用する手順 - 評価器学習済み点群を描画して PSNR を出す仕組み。実装ごとにレンダラ・背景色・8 bit 化の扱いが違い、自分のレンダラで学習した点群を約
1.9 dB有利に評価する - densify学習中に点を複製・分割して増やす処理。最終点数を決め、msplat との速度差の主因と考えている
前提となる用語
- 3DGS-MCMC点の追加・削除 (densify) を、確率的サンプリング手法 MCMC (マルコフ連鎖モンテカルロ法) の考え方で置き換えた学習法 (Kheradmand ら, 2024)。点を増やす代わりに不要な点を別の場所へ移し替え、ノイズを加えて探索させる
- scale 正則化項各ガウシアンの大きさ (楕円体の 3 軸の長さ) が大きくなりすぎないよう損失に加える罰則項。本実装ではこれ単独で PSNR が
4.4 dB下がった - 成分ごとの切り分け (ablation)複数の変更を 1 つずつ ON/OFF して、どの成分が効いている (悪さをしている) かを特定する実験
- NeRF Synthetic / 物体中心のデータCG で作った 8 物体 (Lego, ficus, materials, drums など) を周囲から描画したデータセット。背景が透明で物体が中央にある。学習 100 / 検証 100 / テスト 200 視点
- Mip-NeRF 360 / bicycle実写の 360° 撮影データセット。bicycle は屋外で自転車とベンチを撮ったシーンで、背景が遠くまで広がる点が合成データと違う
- refine / 停止反復 / 点数上限refine は学習中に点を複製・分割・削除する処理。停止反復はそれを止める反復数、点数上限は点の数の上限
- opacity リセット一定間隔で全点の不透明度を小さな値に戻し、不要な点が自然に消えるようにする処理 (標準は 3,000 反復ごと)
- 初期点群学習開始時の点の配置。実写では撮影画像から推定した 3D 点を使い、偏っていると描けない領域が残る
- 反復 (iteration)学習画像を 1 枚選んで描画 → 誤差計算 → パラメータ更新を行う 1 回分。本実装の標準は 12,500 反復、msplat と brush は 30,000 反復
- プロファイル処理のどこにどれだけ時間がかかっているかを測ること
- 再生ベンチ / σ学習済み点群を固定して 1 反復分の時間だけを繰り返し測るベンチマーク。σ は標準偏差 (ばらつきの大きさ)
- タイルへの振り分け画面を 16×16 画素のタイルに分け、各点がどのタイルに映るかを求めてタイルごとに深さ順に並べる処理
- warp / SIMD グループGPU で同じ命令を同時に実行する 32 スレッドのまとまり。1 スレッドが 1 画素を担当する
- 累積和 (scan) / 間接ディスパッチ累積和はソートで各要素の書き込み位置を決める計算。間接ディスパッチは GPU が計算した個数でそのまま次の処理を起動する仕組みで、CPU への読み戻し待ちが要らない
- GPU 稼働率学習時間のうち GPU が実際に計算している時間の割合
- StopThePop画素ごとに深さを並べ直して描画のちらつきを防ぐ手法 (Radl ら, 2024)。タイル判定を厳密にして無駄な計算を減らす効果もある
- splat 単位の逆伝播逆伝播で「1 スレッド = 1 画素」ではなく「1 スレッド = 1 点」として勾配を集める方式。brush が採用
- Adam / メモリ帯域Adam は勾配から各パラメータの更新量を計算する最適化手法で、毎反復すべての点のパラメータを読み書きする。メモリ帯域は 1 秒あたりに読み書きできる量 (M4 Max で約 410 GB/s)
- 8 bit 化 / 値の制限 (clamp)描画結果を 0〜255 の整数に丸めてから PSNR を計算すること。丸める前に値を 0〜1 に制限するかどうかが評価器で違う
前回からの継続語 (再掲)
- 3D Gaussian Splatting (3DGS)3D シーンを多数の小さなガウシアン (楕円体) で表現してリアルタイムに描画する手法。原著は Kerbl et al. 2023
- Apple Silicon / ユニファイドメモリApple 製の独自 SoC。CPU と GPU が同じ物理メモリを共有する
- brushRust + wgpu 製の既存 3DGS 実装。今回、同日比較で学習時間
417 s - 前景背景処理の慣習透明背景のデータを白背景で合成して扱うか、premultiplied で扱うかの違い。msplat は白背景、本実装と brush は premultiplied
- PSNR / 検証 100 視点PSNR は画像品質指標 (dB、高いほど良い)。本資料の値はすべて NeRF Synthetic の検証 100 視点
想定問答
| 想定質問 | 回答骨子 |
|---|---|
| 第 3 回で「brush より +0.63 dB」と言っていたのは間違いだったのか? | 測定自体は正しいが、本実装の評価器で測った値だった。brush の評価器で測ると逆転する (Lego で本実装 35.58 vs brush 37.41)。どちらの評価器も自分のレンダラで学習した点群を約 1.9 dB 有利に評価するため、品質で上回るとは言えない、と訂正した |
| 評価器でなぜそんなに差が出るのか? | 原因はまだ特定していない。見つかっている違いは、8 bit 化の前に値を [0,1] に制限するかどうか (本実装はする、brush はしない) と背景色。短い学習では差がほぼ無く (500 反復で 0.01 dB)、30,000 反復で 2.8 dB まで開く。今後の方針の最初の項目 |
| 結局、品質は良いのか悪いのか? | 各実装が自分の評価器で測った値同士では msplat と互角、brush には 1.0 dB 劣る。図 2 の見た目では、影のキャタピラ付近で本実装にノイズ、msplat はギアがぼやける。「同等水準だが brush がやや上」が正直なところ |
| 12,500 反復で比べれば msplat より速いのでは? | 標準設定同士 (本実装 12,500 / msplat 30,000) なら約 0.75 倍の時間で終わるが、反復数が違う比較なので主張しない。同じ 30,000 反復では 2.5 倍遅い |
| msplat との 2.5 倍の差は何が原因? | 最終点数の比が 2.56 倍でほぼ一致し、1 点・1 反復あたりの処理時間は msplat の 0.92 倍なので、GPU 処理の効率ではなく densify で点が多いことが主因と考えている。msplat の平均点数は推定値なので、実測し直して確かめる |
| -84% の中で一番効いたのは何か? なぜそんなに無駄があったのか? | タイル振り分け用バッファの常駐化 (-48.4%)。毎反復、実需要の約 80 倍の容量のバッファを確保し直しており、ページフォールトが大量に出ていた。カーネルではなくメモリ管理がボトルネックだったのは、ユニファイドメモリ環境らしい知見 |
| 採用した 10 手法で画質は本当に変わっていないのか? | すべて計算結果を変えない変更で、出力の一致をテストで確認している。PSNR も全段階で 36.14〜36.24 dB に収まり、他の 3 シーンでも 5 月と差が小さい |
| 学習時間が 122.8〜126.1 s と幅があるのはなぜ? | 長時間連続で計測すると原因不明の +3〜6% の遅れが出るため。同日の対照計測では 122.8 s、静かな環境の再計測では 126.1 s だったので、幅で報告している |
| MCMC は完全に諦めるのか? | 研究としては打ち切り。scale 正則化項が単独で -4.4 dB 悪化させることまでは特定したが、除いても 30,000 反復で 14.7 dB。卒論では「うまくいかなかった検討」として原因の切り分けまで記述する |
| 実写 (bicycle) の -9.7 dB はどうするのか? | refine の停止反復と点数上限を変えても +0.05 dB だったので、原因は別 (opacity リセット間隔、densify 閾値、初期点群の偏りなど)。卒論の評価範囲は合成・物体中心のデータに絞る |
時間配分の目安
質疑応答で 3〜6 分を見越し、全体 9〜12 分の枠を想定する。